
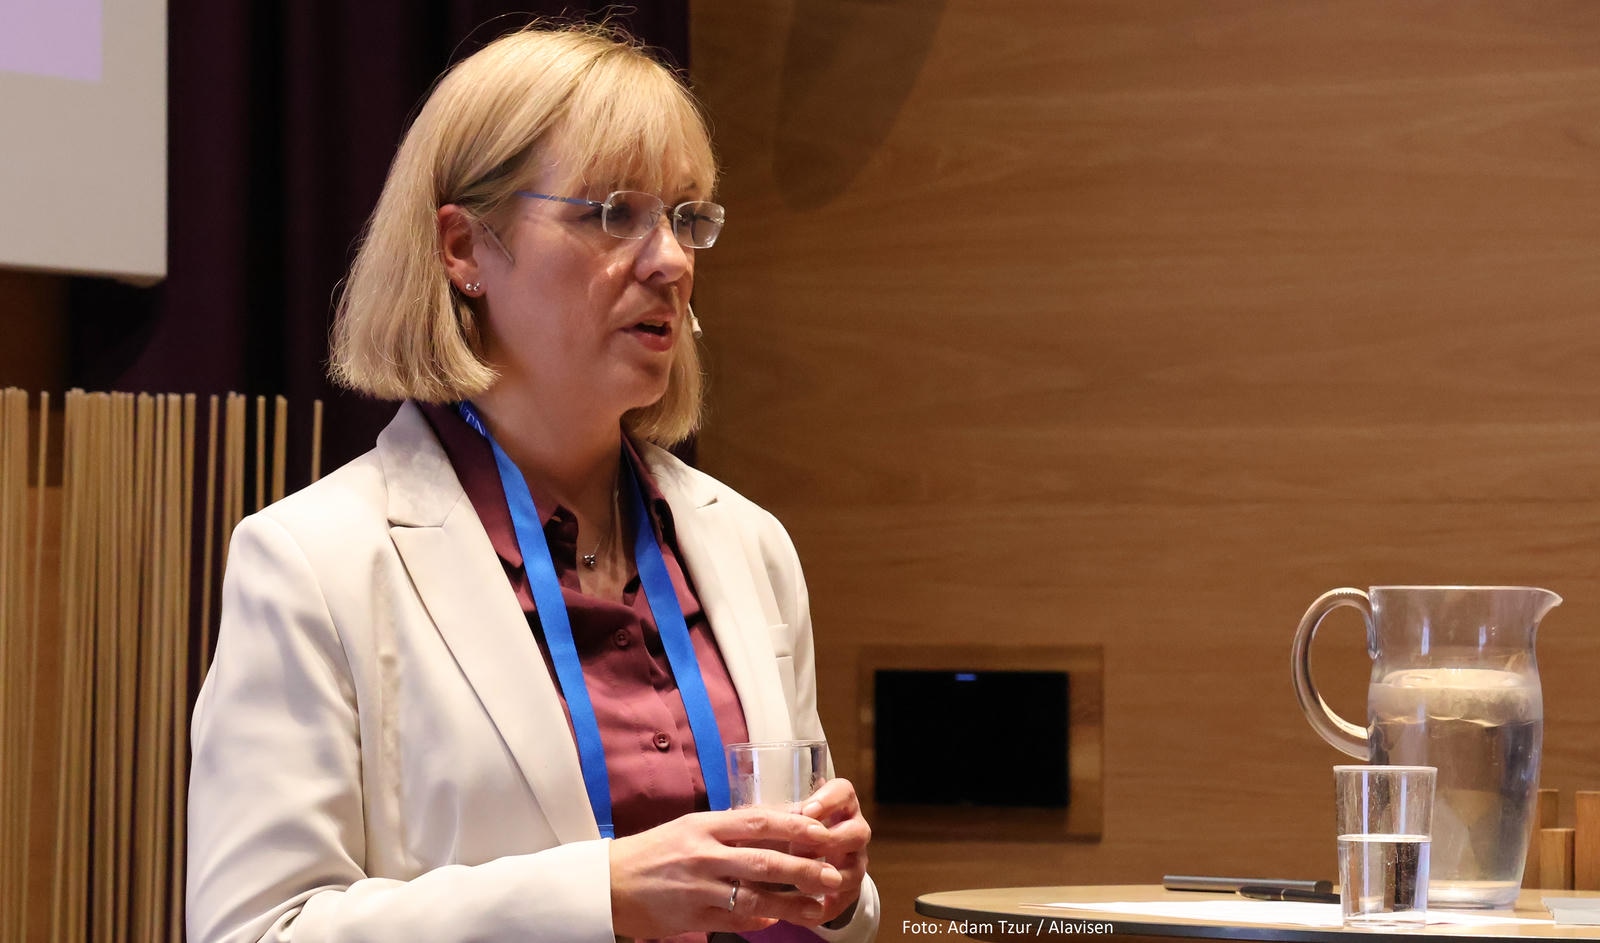

Under NorwAI Innovate holdt Åse Wetås et innlegg om fremtiden for norsk KI.
Hun åpnet med spørsmålet: «Hvorfor trener Nasjonalbiblioteket store språkmodeller?»
Kulturpolitikk som utgangspunkt
Wetås sa at kulturpolitikken støtter verdier som demokrati, ytringsfrihet og inkluderende fellesskap.
Den bygger på Grunnlovens paragraf 100 om ytringsfrihet.
Paragrafen pålegger staten å legge til rette for infrastruktur for en åpen og opplyst offentlig samtale.
Politikken peker på norsk og samisk språk som en forutsetning for denne infrastrukturen.
Saken fortsetter under bildet.
Norske KI-stemmer
Wetås sa at Nasjonalbiblioteket utvikler nye norske modeller for tekst til tale.
De har enda ikke fått et navn, men kommer snart.
De har også videreutviklet transkriberingsverktøy. Før brukte de NB-Whisper. Nå er det «Lunde» som gjelder.
Wetås sa at Lunde er en modernisert versjon av NB-Whisper. Den kommer i løpet av 2026.
Borealis 2.0 er her
Samtidig har den norske språkmodellen Borealis blitt oppdatert.
Utviklingen gikk i fire trinn:
- 2018: NB AI Lab ble opprettet.
- 2024: Mímir-prosjektet trente modellene.
- 2025: Regjeringen ga mandat og finansiering.
- 2026: Avtale med norske mediehus for trening på artikler og nyheter som er beskyttet av opphavsrett.
Stor interesse i norske modeller
Wetås sa at det er en åpenbar interesse for modellene.
Borealis 1.0 er lastet ned omtrent 35 000 ganger siden påsken 2026.
Borealis 2.0 er lastet ned omtrent 3000 ganger.
Hun sa at Norge trenger mer forskning på store språkmodeller.
Nasjonalbiblioteket utfører en forvaltningsoppgave når de leverer språkteknologi til det norske samfunnet.
Biblioteket vil dele data og kompetanse, innenfor rammene av åndsverkloven, avsluttet hun.

